Bulkhead: isolando falhas para não afundar o navio inteiro
Como separar recursos entre dependências para que uma delas, lenta, não derrube o serviço todo
Um serviço de checkout chama três dependências: estoque, frete e um serviço de recomendações que sugere produtos na tela de confirmação. Numa sexta à noite, o serviço de recomendações começa a responder em oito segundos em vez de oitenta milissegundos. Ele não está fora do ar, não devolve erro, só está lento. O circuit breaker não abre, porque as chamadas acabam dando certo. Mas cada uma delas segura uma thread do checkout por oito segundos, e em poucos minutos todas as threads do servidor estão paradas esperando recomendações. O checkout para de responder, inclusive para quem só queria calcular o frete. Uma funcionalidade secundária derrubou a principal.
De onde vem o nome
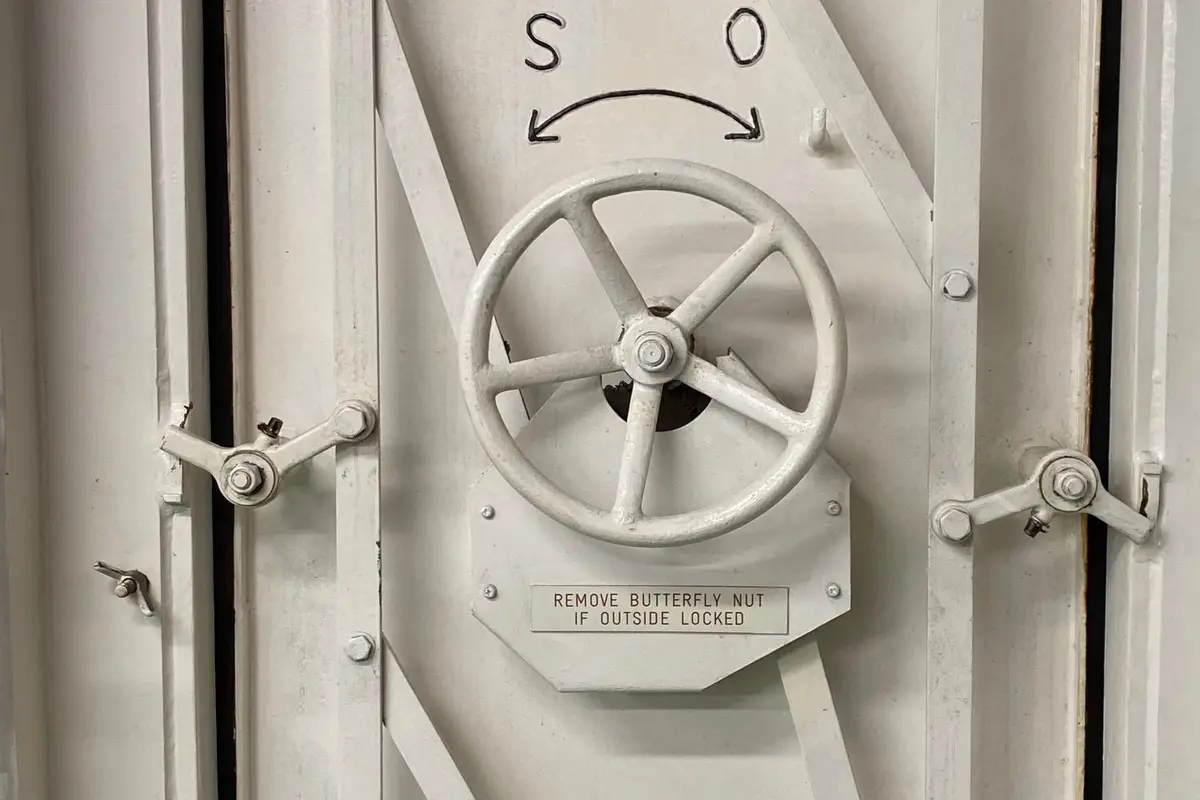
Navios são divididos em compartimentos estanques, chamados de anteparas (bulkheads, em inglês). Se o casco é furado num ponto, a água inunda só aquele compartimento, e o resto do navio continua flutuando. Sem essas divisões, um único furo enche o casco inteiro.
O padrão aplica a mesma ideia aos recursos de um serviço. Em vez de todas as dependências disputarem o mesmo pool de threads ou conexões, cada uma recebe uma cota própria. Se uma dependência fica lenta e esgota a sua cota, as chamadas excedentes para ela falham na hora, enquanto as outras dependências continuam com seus recursos intactos.
O problema do pool compartilhado
Por padrão, a maioria dos servidores web atende requisições com um único pool de threads. No caso do checkout, isso significa que uma requisição que precisa de estoque e uma que precisa de recomendações competem pelas mesmas threads. Enquanto todas as dependências respondem rápido, ninguém percebe. Quando uma delas degrada, ela vai acumulando threads presas até não sobrar nenhuma.
public Checkout montar(Pedido pedido) {
    Estoque estoque = estoqueClient.reservar(pedido);
    Frete frete = freteClient.calcular(pedido);
    List<Produto> sugestoes = recomendacaoClient.sugerir(pedido);
    return new Checkout(estoque, frete, sugestoes);
}
Nada aqui limita quanto tempo ou quantas threads a chamada de recomendações pode consumir. Um timeout ajuda, mas não resolve sozinho: com um timeout de dois segundos e tráfego alto, ainda dá para ter centenas de threads presas ao mesmo tempo esperando esses dois segundos passarem.
Bulkhead por semáforo
A forma mais simples de implementar o padrão é com um semáforo: um contador que limita quantas chamadas simultâneas podem estar em andamento para uma dependência. A chamada continua rodando na thread de quem chamou, mas só entra se houver vaga.
BulkheadConfig config = BulkheadConfig.custom()
    .maxConcurrentCalls(10)
    .maxWaitDuration(Duration.ofMillis(50))
    .build();

Bulkhead bulkhead = Bulkhead.of("recomendacoes", config);

Supplier<List<Produto>> protegido = Bulkhead
    .decorateSupplier(bulkhead, () -> recomendacaoClient.sugerir(pedido));
Com essa configuração do Resilience4j, no máximo dez chamadas para recomendações acontecem ao mesmo tempo. A décima primeira espera até 50 milissegundos por uma vaga e, se não conseguir, recebe uma BulkheadFullException imediatamente. No cenário da sexta à noite, isso significa que no pior caso dez threads ficam presas esperando recomendações, e todas as outras continuam livres para atender estoque e frete.
Bulkhead por pool de threads
A outra variação dá a cada dependência um pool de threads exclusivo. A chamada deixa de rodar na thread de quem chamou e passa a rodar num executor separado, com tamanho e fila próprios.
ThreadPoolBulkheadConfig config = ThreadPoolBulkheadConfig.custom()
    .coreThreadPoolSize(5)
    .maxThreadPoolSize(10)
    .queueCapacity(20)
    .build();

ThreadPoolBulkhead bulkhead = ThreadPoolBulkhead.of("recomendacoes", config);

CompletionStage<List<Produto>> sugestoes = bulkhead
    .executeSupplier(() -> recomendacaoClient.sugerir(pedido));
A vantagem é um isolamento mais forte: quem chamou não fica bloqueado, e dá para combinar com um timeout que de fato libera a thread de origem. O custo é a complexidade de lidar com código assíncrono e o overhead de troca de contexto entre threads. Na prática, o semáforo resolve a maioria dos casos e é por onde eu começaria; o pool dedicado compensa quando você precisa de timeouts mais rígidos ou quando a chamada já é naturalmente assíncrona. Com virtual threads a conta muda um pouco: threads bloqueadas deixam de ser um recurso tão escasso, então um pool dedicado perde parte do sentido. O semáforo, por outro lado, continua útil, porque as conexões e a capacidade da dependência do outro lado seguem sendo finitas.
Escolhendo os números
O limite de chamadas simultâneas é o ajuste mais importante, e chutar é a forma mais comum de errar. Uma referência razoável é a Lei de Little: a quantidade média de chamadas em andamento é a vazão multiplicada pela latência. Se o checkout faz 100 chamadas por segundo para recomendações e cada uma leva 80 milissegundos, existem em média 8 chamadas simultâneas. Um limite de 10 a 15 dá folga para picos sem deixar a dependência sequestrar o servidor quando a latência explodir.
Limite baixo demais rejeita chamadas legítimas em dias normais de tráfego. Limite alto demais equivale a não ter bulkhead nenhum. Vale olhar as métricas de chamadas simultâneas e rejeições que a biblioteca expõe e ajustar com dados reais, em vez de definir uma vez e esquecer.
O que fazer quando o compartimento enche
Uma BulkheadFullException precisa de um destino, e é aqui que o padrão mostra seu valor. No exemplo do checkout, recomendações são opcionais: a tela de confirmação funciona perfeitamente sem elas.
List<Produto> sugestoes = Try.ofSupplier(protegido)
    .recover(BulkheadFullException.class, ex -> List.of())
    .get();
Devolver uma lista vazia mantém o checkout de pé, e o usuário provavelmente nem percebe que faltou alguma coisa. Para dependências essenciais, como o estoque, o fallback pode ser um erro claro e rápido em vez de uma espera longa. O que importa é que a falha fique contida no compartimento dela.
Bulkhead, circuit breaker e timeout juntos
Os três se complementam. O timeout limita quanto tempo uma chamada individual pode durar. O bulkhead limita quantas chamadas podem estar presas ao mesmo tempo. O circuit breaker para de tentar quando a dependência está claramente falhando. No cenário do começo do post, só o bulkhead teria salvado o checkout, porque as chamadas lentas não eram falhas aos olhos do circuit breaker.
Na hora de combinar, o bulkhead costuma ficar na camada mais interna, logo em volta da chamada real, com o circuit breaker por fora dele. Assim, um circuito aberto rejeita a chamada antes mesmo dela ocupar uma vaga no compartimento. Se houver retry na composição, vale configurá-lo para não retentar BulkheadFullException: tentar de novo imediatamente só aumenta a pressão sobre um compartimento que já está cheio.
Quando vale a pena
Nem todo serviço precisa de bulkhead em todas as chamadas. O padrão compensa quando um mesmo serviço depende de várias dependências externas com níveis de criticidade diferentes, principalmente quando alguma delas é secundária e pode ser sacrificada sem prejudicar o fluxo principal. Se você já viu uma funcionalidade que ninguém considerava importante derrubar o sistema inteiro só por ficar lenta, essa é a dependência que deveria estar no seu próprio compartimento.