Grandes bugs da história e o que eles ainda ensinam
Ariane 5, Therac-25 e Knight Capital: três desastres que não foram causados só por uma linha de código
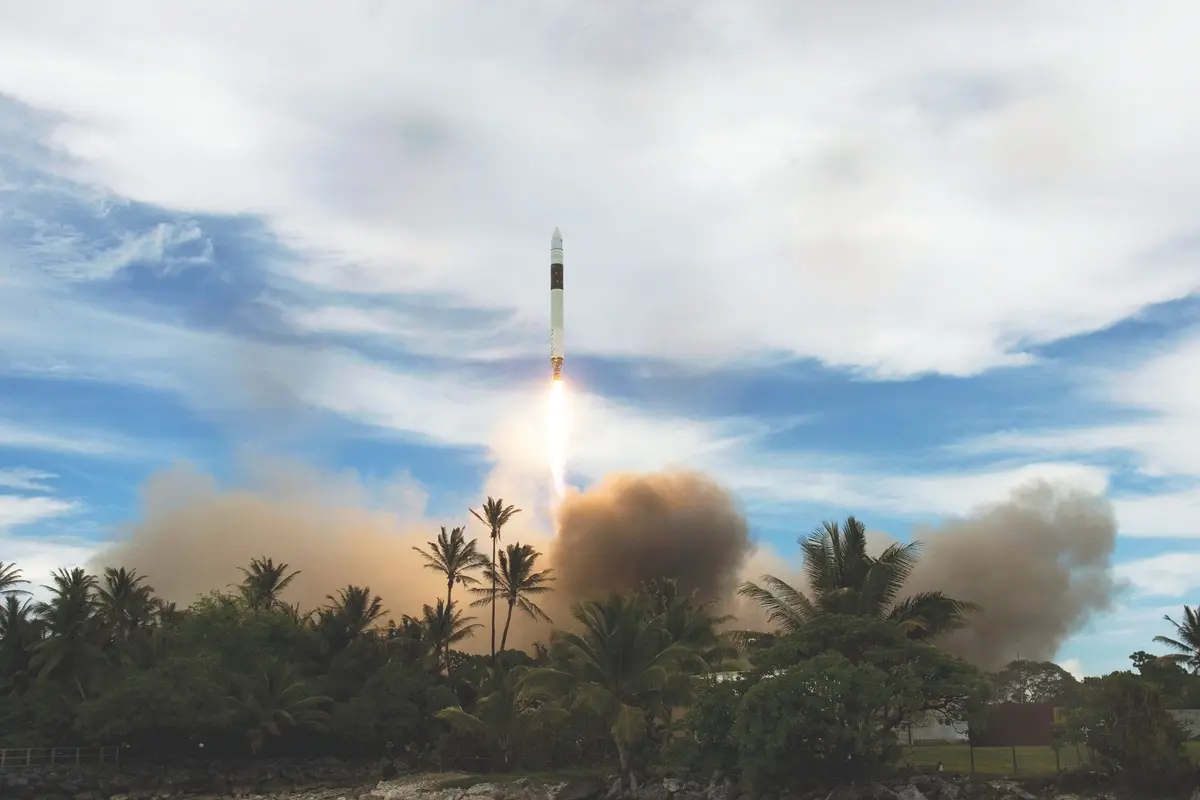
Todo dev tem uma história de bug em produção. Um deploy na sexta, um null que ninguém esperava, um job que rodou duas vezes. A maioria termina com um rollback, um postmortem e uma piada no canal do time. Alguns poucos bugs, porém, terminaram com um foguete explodindo, pacientes mortos ou uma empresa quebrada em menos de uma hora.
Esses casos viraram material de estudo em cursos de engenharia, e não por serem exóticos. O que chama atenção quando você lê os relatórios oficiais é como o erro técnico em si é banal: um overflow, uma condição de corrida, uma flag reaproveitada. Qualquer um de nós já escreveu algo parecido. O que transformou esses erros em desastres foi tudo o que estava em volta deles.
Ariane 5: o código que funcionava perfeitamente
Em 4 de junho de 1996, a Agência Espacial Europeia lançou pela primeira vez o Ariane 5, um foguete novo, maior e mais potente que o antecessor. Cerca de 40 segundos depois da decolagem, ele desviou bruscamente da trajetória, começou a se desintegrar pelas forças aerodinâmicas e foi destruído pelo sistema de autodestruição. Levava a bordo os satélites da missão Cluster.
A comissão de investigação, presidida pelo matemático Jacques-Louis Lions, chegou a uma causa bem específica. O sistema de referência inercial, que informa ao computador de bordo a posição e a velocidade do foguete, tinha um trecho que convertia um valor de ponto flutuante de 64 bits, relacionado à velocidade horizontal, para um inteiro com sinal de 16 bits. O valor ficou maior do que cabia em 16 bits, a conversão gerou uma exceção, e essa exceção não estava tratada. O sistema simplesmente desligou.
Até aqui parece um bug de iniciante. Os detalhes é que tornam o caso interessante:
- O código veio do Ariane 4, onde voou por anos sem problema. Na trajetória do Ariane 4, aquele valor nunca chegava perto do limite. O Ariane 5 seguia uma trajetória diferente, com velocidade horizontal bem maior, muito além do que o código antigo tinha visto.
- Alguns valores eram protegidos contra overflow e outros não. A equipe original tinha analisado quais variáveis podiam estourar e deixou algumas sem proteção para economizar processamento, com base em premissas sobre a física do Ariane 4. Ninguém revisitou essas premissas para o foguete novo.
- Aquele cálculo nem precisava estar rodando. A função servia para o alinhamento antes do lançamento e, por um motivo operacional do Ariane 4, seguia rodando por cerca de 40 segundos depois da decolagem. No Ariane 5 ela não tinha utilidade nenhuma depois que o foguete saía do chão, e o foguete se perdeu justamente dentro dessa janela.
- A redundância não ajudou. Havia dois sistemas inerciais, um de reserva. Os dois rodavam o mesmo software, com os mesmos dados, e falharam da mesma forma com uma fração de segundo de diferença.
- O desligamento foi a reação “segura” projetada. A filosofia era que uma exceção indicava falha de hardware, e nesse caso desligar e passar para o backup fazia sentido. Para um erro de software, que acontece igual nas duas cópias, essa decisão derrubou tudo.
E o último golpe: quando o sistema inercial caiu, ele enviou dados de diagnóstico pelo barramento. O computador de bordo interpretou esses dados como se fossem informações de voo e comandou os bocais dos motores para uma deflexão extrema.
A lição
Reaproveitar código é reaproveitar as premissas dele. O módulo do Ariane 4 não tinha bug no contexto para o qual foi escrito. O bug nasceu quando o contexto mudou e ninguém conferiu se as suposições implícitas ainda valiam. Isso acontece toda semana em software comum: uma biblioteca interna que assumia uma moeda, um serviço que assumia que o volume nunca passaria de mil itens, um campo que “nunca vem nulo”.
A outra lição é sobre redundância. Duas cópias do mesmo código protegem contra falha de hardware, não contra falha de lógica. Se as duas réplicas do seu serviço recebem a mesma mensagem envenenada, as duas vão cair. É por isso que ideias como circuit breaker e isolamento de falhas importam mais do que simplesmente ter mais instâncias.
Therac-25: quando o software substituiu a trava física
O Therac-25 era uma máquina de radioterapia fabricada pela AECL, uma estatal canadense, usada em hospitais dos Estados Unidos e do Canadá nos anos 1980. Entre 1985 e 1987, ela aplicou doses de radiação muito acima do prescrito em pelo menos seis pacientes. Pelo menos três morreram em decorrência das overdoses.
A máquina tinha dois modos principais. No modo de elétrons, aplicava um feixe de baixa intensidade diretamente no paciente. No modo de raio X, gerava um feixe de altíssima intensidade que passava por um alvo metálico antes de chegar ao corpo, e era esse alvo que convertia e atenuava a radiação. Se o feixe de alta intensidade saísse sem o alvo na frente, o paciente recebia uma dose brutal.
Os modelos anteriores, Therac-6 e Therac-20, tinham travas de hardware que impediam fisicamente essa combinação. No Therac-25, a AECL removeu essas travas e passou a confiar no software para garantir a segurança.
O bug mais conhecido era uma condição de corrida. O operador digitava os parâmetros do tratamento num terminal. Se ele errasse o modo, digitando “x” no lugar de “e”, e corrigisse rapidamente, em poucos segundos, a interface mostrava o valor correto, mas parte do sistema já tinha configurado o hardware com a informação antiga. Operadores experientes, justamente por digitarem rápido, eram os que conseguiam disparar a falha. Nos testes, ela nunca tinha aparecido.
Havia ainda outro defeito, independente: uma variável de um byte era incrementada repetidamente durante a configuração e, a cada 256 incrementos, voltava a zero. Quando estava em zero, uma checagem de posicionamento era pulada. Se o operador apertasse um botão exatamente nesse instante, o feixe saía sem a verificação.
E, como no Ariane, o que está em volta do bug pesa tanto quanto ele:
- As mensagens de erro eram incompreensíveis. A máquina mostrava algo como “MALFUNCTION 54”, sem explicação, e o manual não ajudava. Como erros apareciam com frequência no uso normal, os operadores aprenderam a apertar a tecla para continuar o tratamento.
- O código tinha sido herdado do Therac-20, onde os mesmos defeitos provavelmente já existiam, mas eram mascarados pelas travas físicas. O hardware estava escondendo os bugs do software.
- A empresa demorou a acreditar. Os primeiros relatos foram tratados como impossíveis, já que a análise de segurança considerava o software confiável. As correções iniciais miravam problemas de hardware que não eram a causa.
A pesquisadora Nancy Leveson, que escreveu a análise mais citada do caso, insiste num ponto: não dá para reduzir o Therac-25 a “um bug de concorrência”. Foi um processo de engenharia inteiro que confiou demais no software, testou de menos e não tinha mecanismo para ouvir quem estava usando a máquina.
A lição
Não remova uma proteção só porque acha que outra camada cobre o caso. Defesa em profundidade existe porque cada camada falha de um jeito diferente. No dia a dia isso aparece como validação só no frontend, permissão checada só no gateway, constraint de banco removida “porque a aplicação já valida”.
Também vale olhar para as mensagens de erro e para os alertas do seu sistema com outros olhos. Se o erro aparece toda hora e as pessoas aprenderam a ignorá-lo, ele deixou de ser um erro e virou ruído. No dia em que for sério, ninguém vai notar. Esse é o mesmo problema de logs que não ajudam e de alertas que tocam por qualquer coisa.
Knight Capital: 45 minutos
A Knight Capital era uma das maiores empresas de negociação de ações dos Estados Unidos. Na manhã de 1º de agosto de 2012, ela perdeu cerca de 460 milhões de dólares em aproximadamente 45 minutos. A empresa precisou de um resgate às pressas e acabou sendo adquirida meses depois.
O relatório da SEC, a CVM americana, conta a história com detalhes. A Knight ia participar de um novo programa da Bolsa de Nova York e precisava atualizar o sistema de roteamento de ordens. O deploy foi feito manualmente em oito servidores, alguns dias antes. Um técnico não copiou o código novo para um deles. Ninguém revisou, e não havia nenhum processo automático para verificar se os oito estavam iguais.
Até aí, seria um problema contido: um servidor desatualizado. Só que o código novo reaproveitava uma flag que, no passado, ativava uma funcionalidade antiga chamada Power Peg. O Power Peg estava sem uso havia anos, mas o código continuava lá. No servidor que ficou com a versão velha, a flag ligada não ativou a funcionalidade nova. Ativou o Power Peg.
E o Power Peg estava quebrado de um jeito particularmente perigoso. Anos antes, uma refatoração tinha mudado o lugar onde o sistema contava quantas ações já tinham sido executadas. Como a funcionalidade estava desativada, ninguém percebeu que ela tinha perdido esse controle. Quando voltou à vida, ela simplesmente continuou enviando ordens, sem saber que os pedidos já tinham sido atendidos.
Quando o mercado abriu, esse servidor começou a disparar milhões de ordens. Alguns detalhes do relatório doem de ler:
- Houve aviso. Antes da abertura, o sistema mandou 97 e-mails automáticos mencionando um erro no Power Peg. Eles não tinham sido pensados como alerta, e ninguém agiu a partir deles.
- Não existia um botão de parar. A empresa não tinha um procedimento documentado para desligar o sistema em caso de comportamento anômalo.
- O rollback piorou tudo. Sem entender a causa, a equipe reverteu o código novo nos outros sete servidores. Mas a flag continuou ligada, e agora os oito servidores rodavam a versão antiga com o Power Peg ativado.
A lição
São várias, e todas muito atuais:
- Código morto não é inofensivo. Se uma funcionalidade não é usada, remova. Código parado não recebe testes, não acompanha refatorações e um dia pode voltar a rodar.
- Não reaproveite flags. Uma flag com significado antigo e novo é uma armadilha esperando o servidor errado. Isso vale tanto para feature flags quanto para campos de banco e códigos de status em APIs.
- Deploy manual não escala. Oito servidores, um esquecido. Automação e verificação de que todas as instâncias estão na mesma versão teriam evitado o problema inteiro.
- Rollback não é automaticamente seguro. Voltar o código sem voltar a configuração pode criar uma combinação que nunca existiu antes.
- Tenha um kill switch. Se o sistema pode causar dano rápido, alguém precisa conseguir pará-lo rápido, com um procedimento conhecido.
O que os três têm em comum
Com os três casos lado a lado, fica claro que em nenhum deles o bug sozinho explica o desastre.
No Ariane, o overflow só importou porque o código foi reutilizado sem revisar premissas, porque rodava uma função inútil e porque a redundância era idêntica. No Therac-25, a condição de corrida só matou porque a trava física foi removida, porque os erros eram ignorados por hábito e porque a empresa não escutou os relatos. Na Knight, a flag só causou o prejuízo porque havia código morto, deploy manual, alertas ignorados e nenhum jeito de parar o sistema.
O psicólogo James Reason deu um nome para isso: o modelo do queijo suíço. Cada camada de proteção tem furos, e o acidente acontece quando os furos de várias camadas se alinham. A consequência prática é libertadora e incômoda ao mesmo tempo. Libertadora porque você não precisa escrever código perfeito; ninguém escreve. Incômoda porque cada camada que você remove, cada alerta que você ignora e cada premissa que você não revisita aumenta a chance de os furos se alinharem.
Da próxima vez que alguém disser “esse código funciona há anos, pode reaproveitar”, “não precisa dessa validação, o outro serviço já faz” ou “esse alerta sempre aparece, pode ignorar”, vale lembrar que frases muito parecidas aparecem nos relatórios desses três casos.